第 1 章
云原生概要介绍
根据阿里云官方公告,阿里云云原生工程师 ACA 认证已于 2026 年 8 月 31 日 下线。已取得的证书继续有效,证书有效期为领取之日起两年。后文仅作为 2026 年 8 月学习和备考过程中的相关记录。
为什么需要容器
在容器出现之前,软件交付有一个长期存在的痛点:"在我电脑上能跑"。开发环境、测试环境、生产环境的操作系统版本、依赖库版本、配置项都可能不一样,代码从一个环境搬到另一个环境,经常出问题。
传统的解决办法是虚拟机(Hypervisor 把一台物理机切成多台虚拟机),但虚拟机本身很重——每一台虚拟机都要装一份完整的操作系统,启动要分钟级,资源开销也大。
容器(以 Docker 为代表)解决的正是这个问题:把应用连同它的依赖、配置一起打包成一个镜像,不管在哪台机器上运行,行为都一致;容器共享宿主机内核,不需要装完整操作系统,所以启动是秒级的,开销也小得多。
从云计算到云原生
容器解决了"环境不一致",但马上带来新问题。云原生技术栈,就是一环接一环解决这些新问题长出来的。
1. 容器多了,谁来调度?
一个应用可能拆成几十上百个容器实例,分布在成百上千台机器上。哪个容器该起在哪台机器上、挂了要不要自动重启、要扩容该加几个实例,人工管不过来。于是有了容器编排,事实标准是 Kubernetes(源自 Google 内部的 Borg 系统,2014 年开源),负责调度、服务发现、健康检查、自动伸缩。
2. 单体应用改不动了怎么办?
底层调度问题解决了,应用本身还是一个大单体的话,改一行代码也要整体重新构建、重新发布,团队规模大了互相拖累。服务化(微服务)架构模式的做法是按业务模块拆成独立开发、独立部署、独立伸缩的小服务,服务之间通过标准协议(HTTP、gRPC)和接口契约通信。
3. 服务拆多了,中间件逻辑往哪放?
微服务之间要互相调用,就需要 RPC 框架、注册发现、限流熔断这些中间件能力。如果以 SDK 形式打进每个服务的代码里,业务代码和中间件版本就耦合死了,升级一次 SDK 要重新发布所有服务。Mesh 化架构模式(服务网格) 的思路是把这些中间件能力从业务进程里剥出来,下沉到独立的 Sidecar 进程,业务代码不再感知中间件逻辑,中间件升级和业务发布彻底解耦。
4. 有些场景,连"管几个容器"都嫌多余
一个月只跑一次的定时任务、流量完全随机的接口,为它们长期占着容器资源不划算。Serverless 架构模式把"要不要管服务器"也变成一个可以放弃的选项:用户只写业务逻辑,按调用次数付费,平台负责弹性伸缩,包括缩到零和从零启动。
5. 有状态和无状态混在一起,弹性做不彻底
计算逻辑和数据存储绑在同一个实例里,这个实例就没法说加就加、说减就减,因为数据还在上面。存储计算分离模式把有状态的部分(数据库、存储)和无状态的部分(计算逻辑)拆开,计算层随时扩缩容,存储层留在稳定可靠的地方专心保数据。
6. 微服务各自有自己的数据库,事务怎么保证?
单体应用时代,一个事务用一个数据库的本地事务就能保证一致性。微服务提倡"一个服务一个私有数据源",一次业务操作可能跨好几个服务的数据库,传统的单库事务不再适用。这就需要分布式事务模式,通过 XA、BASE、TCC、SAGA、AT 等方案,在跨服务、跨数据库的场景下保证数据最终正确。
以上服务化、Mesh 化、Serverless 化、存储计算分离、分布式事务,是阿里《云原生架构白皮书》明确给出的五种云原生架构模式。不是每个系统都要五种全用上,而是按业务规模和成熟度选择组合。选择题里容易考一个认知点:云原生不是全有或全无的选择,是一条可以分阶段走的路。
7. 分布式系统里,故障是常态
服务拆得越细,调用链越长,一个下游服务变慢就可能拖垮整条调用链,形成雪崩。这不是"会不会发生"的问题,是"多久发生一次"的问题。应对思路有两层:限流降级提前设计好"允许哪些部分先坏",混沌工程则主动注入故障来验证系统的抗压能力。(具体产品见第 5 章)
8. 出了问题,怎么知道是哪一跳出的?
一次请求可能跨十几个服务,"登录一台机器看日志"在分布式系统里已经不够用了。压测提前摸清系统极限在哪,监控和链路追踪让故障发生时能定位到具体哪个服务出了问题。这一整块能力叫可观测性。(具体产品见第 5 章)
9. 技术栈都到位了,发布流程还是手工?
服务数量上去之后,"改代码 → 测试 → 上线"这条链路还靠人工串行操作的话,团队规模再大也快不起来。DevOps 把交付流程本身也自动化、工程化,用流水线保证每一次发布都可重复、可回滚。(具体见第 6 章)
云原生的官方定义
上面这条因果链落到具体名词上,正好对应 CNCF(云原生计算基金会)对"云原生"的官方定义,而这个定义本身也是逐年扩充的:
| 年份 | CNCF 定义包含的技术 |
|---|---|
| 2015 年成立时 | 容器化封装、自动化管理、微服务化 |
| 2018 年更新后 | 在原有基础上,新增服务网格(Service Mesh)、声明式 API |
"声明式 API"指的是只描述"我要什么最终状态"(比如"我要 3 个副本"),由系统自己想办法达成,而不是一步步命令"先做这个、再做那个"。Kubernetes 的资源定义(YAML)就是声明式 API 的典型体现,也是容器编排能够自动化、自愈的基础:系统持续对比"期望状态"和"实际状态",有差异就自动纠正。
再加上不可变基础设施(容器一旦构建就不在原地修改,要变更就整体替换成新版本,而不是登进去改配置)。容器、编排、微服务、服务网格、声明式 API、不可变基础设施,这六个技术要素加上 DevOps 的工程文化,就是目前公认的云原生核心技术清单。
阿里巴巴与云原生
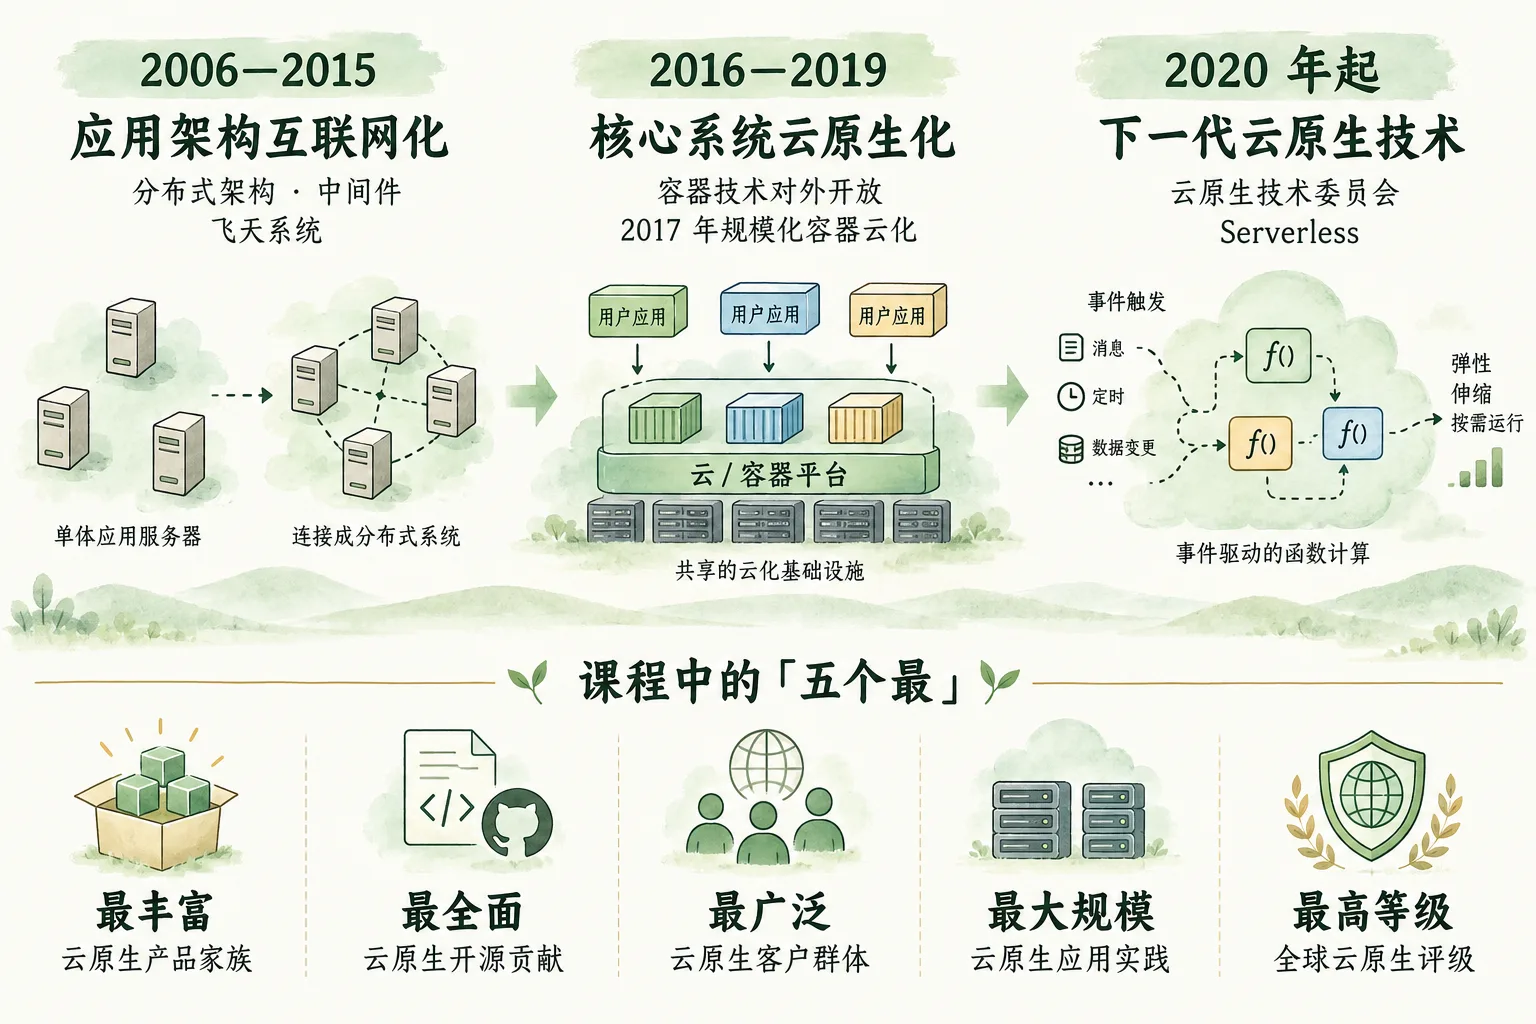
2009 年阿里云成立、启动飞天系统研发;2018 年宣布全面上云战略;2019 年核心交易系统完成全面上云(当年双 11 验证通过)。
这张地图上的每一个名字,都是前面那条因果链里某一环的具体产品化落地。下一章从容器技术基础开始,正式往下走。