第 1 章
Kubernetes 架构与组件
这是 CKA 备考笔记的第一篇。不管后面学调度、网络、存储还是安全,所有东西最终都要回到一张图上——Kubernetes 集群架构图。这篇把它拆清楚。
CKA 考试速览
先搞清楚这个考试考什么、怎么考:
| 项目 | 内容 |
|---|---|
| 考试形式 | 实操,在浏览器终端里用 kubectl 操作真实集群 |
| 时长 | 2 小时,约 15-20 道题 |
| 及格线 | 66% |
| 开卷范围 | 仅限 kubernetes.io(文档 + 博客)和 github.com/kubernetes |
五大考纲域和权重:
| 考纲域 | 权重 |
|---|---|
| Cluster Architecture, Installation & Configuration | 25% |
| Services & Networking | 20% |
| Troubleshooting | 30% |
| Workloads & Scheduling | 15% |
| Storage | 10% |
Troubleshooting 占 30%,是最大头——考试会给你一个坏了的集群让你修。这意味着你不仅要知道每个组件是什么,还要知道它坏了会出现什么症状。
Kubernetes 解决的核心问题
单机跑容器很简单,docker run 一行命令就行。但到了生产环境,问题变成了:
- 多台机器怎么协调? 手动 SSH 到每台机器部署,不现实
- 服务之间怎么找到彼此? 容器 IP 是动态的,不能硬编码
- 怎么不停机更新? 不能每次发版都告诉用户"维护中"
- 资源怎么分配? 哪台机器空闲、哪台快满了,靠人盯不住
Kubernetes 就是来解决这四个问题的。一句话定义:
自动化容器的部署、扩缩和全生命周期管理。
两个设计思想
理解 K8s 的一切行为之前,先记住它的两个底层假设:
解耦(Decoupled):组件之间没有硬依赖。API Server 挂了,已经在跑的 Pod 不会立刻死;Scheduler 和 Controller Manager 是独立进程,各干各的。
瞬态(Transient):K8s 假定任何组件随时会死。不是"万一挂了怎么办",而是"它一定会挂,系统要自愈"。所以你不会去修一个坏掉的 Pod——杀掉它,让 K8s 起一个新的。
这两条合在一起就是 K8s 的核心哲学:不依赖任何单一组件的存活,随时准备好替换任何东西。
集群架构全景
一个 K8s 集群分两大部分:
- Control Plane(控制平面):大脑,负责做决策。生产环境至少 3 个节点保证高可用
- Worker Nodes(工作节点):手脚,实际运行你的应用
所有组件之间只通过 API 调用 通信——没有组件之间的直连。这种 API 驱动的架构也带来了跨平台能力:Worker Node 可以跑 Windows Server(2019/2022),但 Control Plane 必须是 Linux。
注意:kubelet 和 kube-proxy 是每个节点都有的,不只是 Worker——Control Plane 节点上也跑着这两个进程。
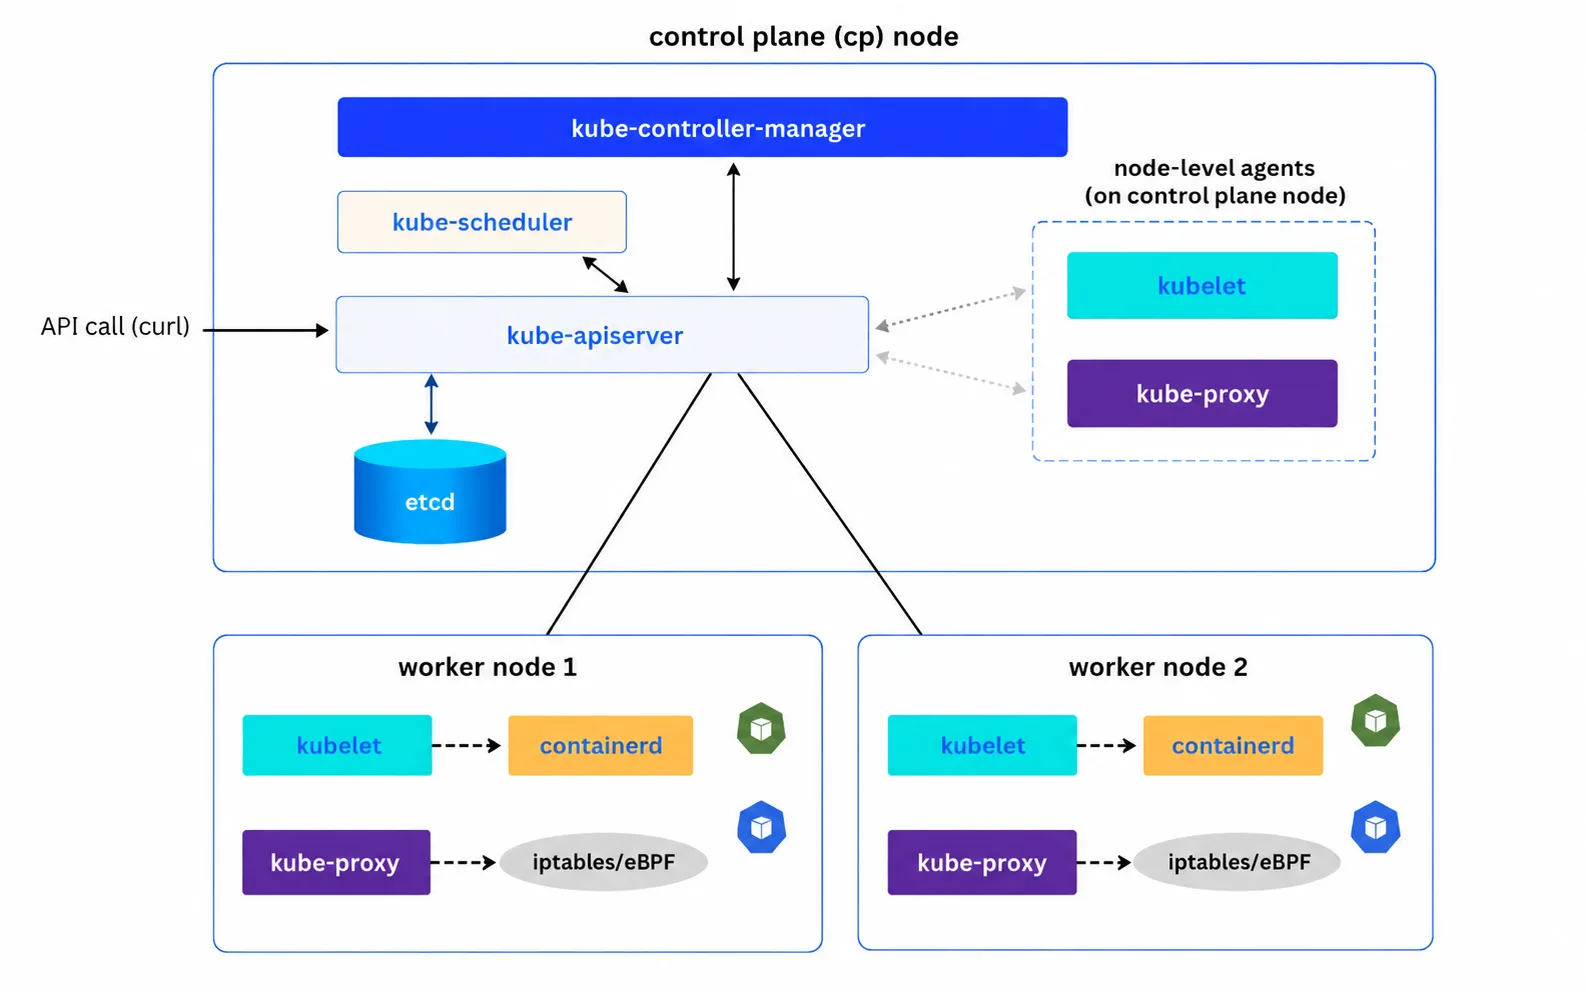
控制平面组件
| 组件 | 职责 | 类比 |
|---|---|---|
| kube-apiserver | 所有通信的唯一入口,kubectl 和其他组件都通过它交互 | 前台——找集群办事都先过它 |
| etcd | 存储集群所有状态数据(JSON 格式),唯一的持久化存储 | 数据库——集群的唯一真相来源 |
| kube-scheduler | 收到新 Pod 的 podSpec 后,决定放到哪个 Node 上 | 调度员——"4 号节点资源够,放那儿" |
| kube-controller-manager | 持续检查集群实际状态是否符合期望状态,不符合就纠正 | 巡检员——"说好 3 副本,只剩 2 个,补一个" |
| cloud-controller-manager | 对接云厂商 API(负载均衡器、云盘等),裸金属环境没有这个 | 可选件 |
要点:只有 API Server 能读写 etcd。 Scheduler、Controller Manager 都通过 API Server 间接访问数据。
工作节点组件
| 组件 | 职责 |
|---|---|
| kubelet | 每个节点上的管家。接收 API Server 发来的 podSpec,调用容器运行时创建容器,持续汇报节点状态。它是系统进程(systemd 管理),不是容器。心跳靠定期续租 kube-node-lease 里本节点的 Lease 对象,太久没续租,节点就被标记为 NotReady |
| containerd | 容器运行时,kubelet 告诉它"起一个容器",它去实际执行 |
| kube-proxy | 维护节点上的网络规则(iptables 或 eBPF),让 Service 的流量能路由到正确的 Pod |
一次部署请求的完整路径
当你执行 kubectl create deployment nginx --replicas=3 时:
- kubectl 把请求发给 API Server
- API Server 验证请求,把 Deployment 写入 etcd
- Controller Manager 里的 Deployment 控制器发现新的 Deployment,创建一个 ReplicaSet
- ReplicaSet 控制器发现 Pod 不够 3 个,创建 3 个 Pod——这时 Pod 还没有分配节点
- Scheduler 发现未调度的 Pod,为每个 Pod 选一个 Node,把节点名写回 API Server
- 对应 Node 上的 kubelet 发现分配给自己的 Pod,准备好卷和配置,调用 containerd 创建容器,再把状态报回 API Server
- Pod 就绪后,Service 背后的 Pod 名单(EndpointSlice)随之更新,各节点的 kube-proxy 据此更新转发规则
每一步都不是谁命令谁,而是各组件 watch 自己关心的对象、自己动手。之后某个 Pod 挂了,也是 ReplicaSet 控制器发现数量不够,建一个新 Pod,再交给 Scheduler 走一遍第 5 步之后的流程。
想看 kubectl 实际发了哪些 API 请求,加 -v=8:kubectl create deployment test --image nginx -v=8,能看到一个发往 /apis/apps/v1/namespaces/default/deployments 的 POST。
传统架构 vs Kubernetes
| 传统模式 | Kubernetes 模式 | |
|---|---|---|
| 应用形态 | 一个大的单体应用 | 多个小的微服务 |
| 扩容方式 | 垂直扩展——买更大的机器 | 水平扩展——多起几个实例 |
| 故障应对 | 想办法修,修不好就宕机 | 杀掉坏的,自动起新的 |
| 服务发现 | 硬编码 IP / 手动配置 | Service 对象 + Label 自动匹配 |
| 部署方式 | SSH + 手动操作 | 声明式配置,一条命令 |
核心术语
Deployment → ReplicaSet → Pod → Container
这是 K8s 里最核心的一条对象层级链:
- Pod:最小调度单位。一个 Pod 包含一个或多个容器,它们共享同一个 IP、同一份存储、同一个网络命名空间。典型用法是一个主容器跑应用,旁边挂 sidecar 容器做日志收集之类的辅助工作。共享的网络命名空间由一个隐藏的 pause 容器持有:它最先启动、什么都不做、一直活着,Pod 的 IP 就在它身上,业务容器重启多少次,IP 都不变
- ReplicaSet:确保指定数量的 Pod 副本始终在运行——少了就创建,多了就终止
- Deployment:管理 ReplicaSet 的上层对象,支持滚动更新、回滚等高级功能。你日常操作的对象基本都是 Deployment,不会直接操作 ReplicaSet
你不直接管 Pod,你管 Deployment;Deployment 管 ReplicaSet;ReplicaSet 管 Pod。三层分工。
Namespace — 隔离边界
把集群切成逻辑分区,用于资源隔离和多租户。有些对象是集群级别的,有些只存在于某个 Namespace 内。跨 Namespace 的 Pod 之间需要通过 Service 通信。
Watch-loop — K8s 的运行机制
K8s 里所有控制器(operator)都是 watch-loop:持续向 API Server 查询某种对象的当前状态,发现实际状态和期望状态不一致就执行操作去修正。kube-controller-manager 内置了多个控制器,还可以通过 CRD(Custom Resource Definition) 扩展自定义控制器。
controller 和 operator 常被混用。一般说 controller 泛指这种控制循环,K8s 内置的都是;operator 多指自定义控制器加 CRD,把某个软件的运维经验写成代码——比如一个数据库 operator,你声明"要一个 3 节点的集群",它负责建主从、做备份、故障切换。Cilium 自带的 cilium-operator 就是这一类。
Service — 稳定的网络入口
Pod 的 IP 是动态的(销毁重建就变了),Service 给一组 Pod 提供一个稳定的访问地址。它通过 Label 匹配找到对应的 Pod,配合 Endpoint 管理网络连接。Service 可以在 Pod 之间、跨 Namespace、以及与集群外部之间提供通信。
Label、Taint 与 Toleration
- Label:贴在任何 K8s 对象上的任意键值对(如
app=nginx),用来筛选、分组和关联对象。管理大规模集群时,Label 比记住每个对象的名字高效得多 - Taint:贴在 Node 上,表示"不要往我这里调度 Pod"
- Toleration:写在 Pod 的 metadata 里,表示"我能容忍这个 Taint,可以调度到那个 Node 上"
官方文档与参考资源
CKA 是开卷考试,但只能查以下网站:
实际考试中 99% 的时间都在查官方文档。文档首页的几个区域各有分工:
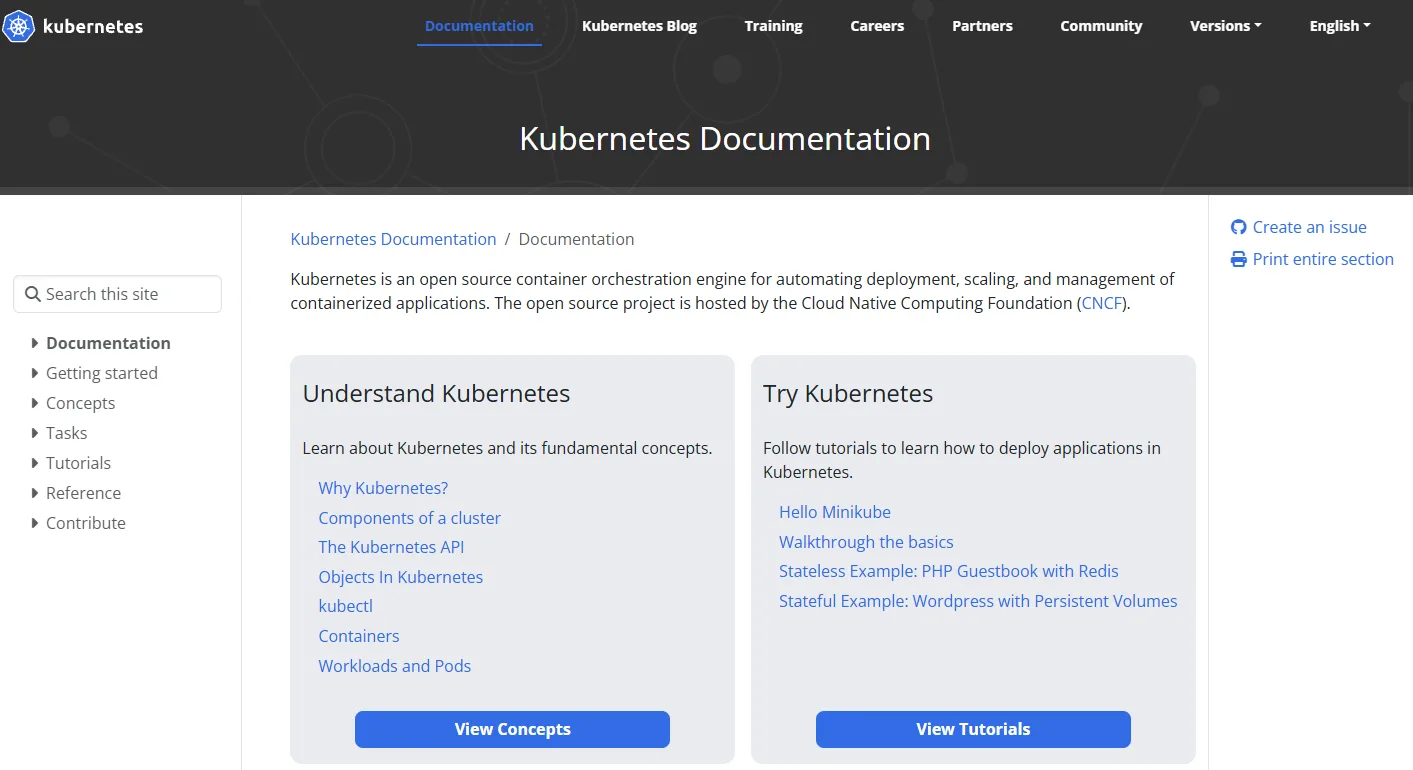
| 区域 | 内容 | 考试中的用途 |
|---|---|---|
| Concepts | 概念解释 | 偶尔确认某个字段或行为的含义 |
| Tasks | 操作指南(step-by-step) | 最常用——直接照着做,可以抄命令和 YAML |
| Reference | API 字段、kubectl 命令参数 | 忘了某个参数名的时候查 |
| Getting started | 入门教程 | 考试中基本不看 |
| Tutorials | 场景实战 | 考试中基本不看 |
考试技巧:用左上角的搜索框比一层层点目录快得多。比如忘了 NetworkPolicy 怎么写,直接搜 "network policy" 就能找到对应的 Tasks 页面。
补充知识
- Kubernetes 源自希腊语"舵手",缩写 K8s(K 和 s 之间 8 个字母)
- 脱胎于 Google 内部系统 Borg,有 15 年大规模生产经验背书
- 2014 年开源,现在是 CNCF 毕业项目
- 用 Go 语言开发
- 每 4 个月一个 minor 版本,大约每 10 天一个 patch 版本
YAML 与 JSON
K8s 的配置文件有两种格式,本质上是同一份数据的不同写法:
# YAML — 人写的格式
apiVersion: v1
kind: Pod
metadata:
  name: nginx
  labels:
    app: web
spec:
  containers:
    - name: nginx
      image: nginx:1.27
      ports:
        - containerPort: 80
// JSON — K8s 内部存储的格式
{
  "apiVersion": "v1",
  "kind": "Pod",
  "metadata": {
    "name": "nginx",
    "labels": {
      "app": "web"
    }
  },
  "spec": {
    "containers": [
      {
        "name": "nginx",
        "image": "nginx:1.27",
        "ports": [
          { "containerPort": 80 }
        ]
      }
    ]
  }
}
| YAML | JSON | |
|---|---|---|
| 用途 | 你写配置、社区分享 | K8s 内部存入 etcd |
| 可读性 | 缩进表示层级,简洁 | 花括号 + 引号,冗长 |
| 注释 | 支持(#) | 不支持 |
| 转换 | kubectl 提交时自动转成 JSON | — |
日常只写 YAML。 kubectl 提交给 API Server 时会自动转成 JSON 再存入 etcd,你不需要手动处理这个转换。考试里也是写 YAML。
CKA 是一场实操考试
CKA没有选择题,考试全程是一个浏览器终端,面前是真实的 Kubernetes 集群,可能是正常的等你操作,也可能是坏的让你修。你需要用 kubectl、kubeadm 和 Linux 命令行解决 15-20 道实操题,2 小时内完成。
这意味着:看懂概念不够,必须动手操作过,常用命令要打到不用想。 考试允许查 kubernetes.io,但得知道去哪找、怎么搜,不能现场慢慢翻。
所以从下一章开始,每一篇笔记都是实操记录。实操练习完后,先用 CKA 考试券自带的 2 次模拟,练习速度,记录回忆题,研究不会做的题,最后再正式考试。